이벤트가 두렵습니다
이벤트때 사용자 트래픽이 폭주하면서 사이트의 응답시간이 느려지기 시작헀습니다.
트레이스 로그들을 보니까 API는 빨랐는데 전부 웹서버에서 부하가 생기고 있었습니다.
API는 빠른데 화면 응답이 너무 느렸습니다. 대부분 Next.js에서 발생한 부하였는데요,
모니터링 툴에서 프로파일링 해보니 2가지 현상이 발견되었습니다.
- Next.js fetch-cache I/O 처리 지연
- 명확한 application span으로 분류하지 못한 런타임 내부 지연
다음 이벤트까지 3일밖에 남지 않았기 때문에, 어떻게든 해결해야 했습니다.
첫 번째 가설. Next 캐시
부하 상황에서 fetch-cache를 메모리에 읽거나 시스템에 쓰는 작업이 지연되고 있었습니다. 당시 환경은 pm2 기반의 클러스터로 구성되어 하나의 서버 내에 여러 대의 Node 인스턴스가 동작하고 있었습니다.
이 인스턴스들은 모두 같은 폴더 하위에서 캐시를 읽거나 쓰고 있었습니다. 각각 다른 인스턴스가 같은 캐시 저장소를 바라볼 수 있도록 개선하면 파일 시스템 I/O 부하가 낮아질 것이고, 곧 성능에 대한 개선으로 이어질 수 있을 것이라 추측했습니다.
곧바로 공유 Redis 캐시를 바라보도록 Next.js의 커스텀 캐시 핸들러를 적용해 보았습니다.
import { createClient } from 'redis';

const redisClient = createClient({
	url: process.env.REDIS_URL
	...
)}
...
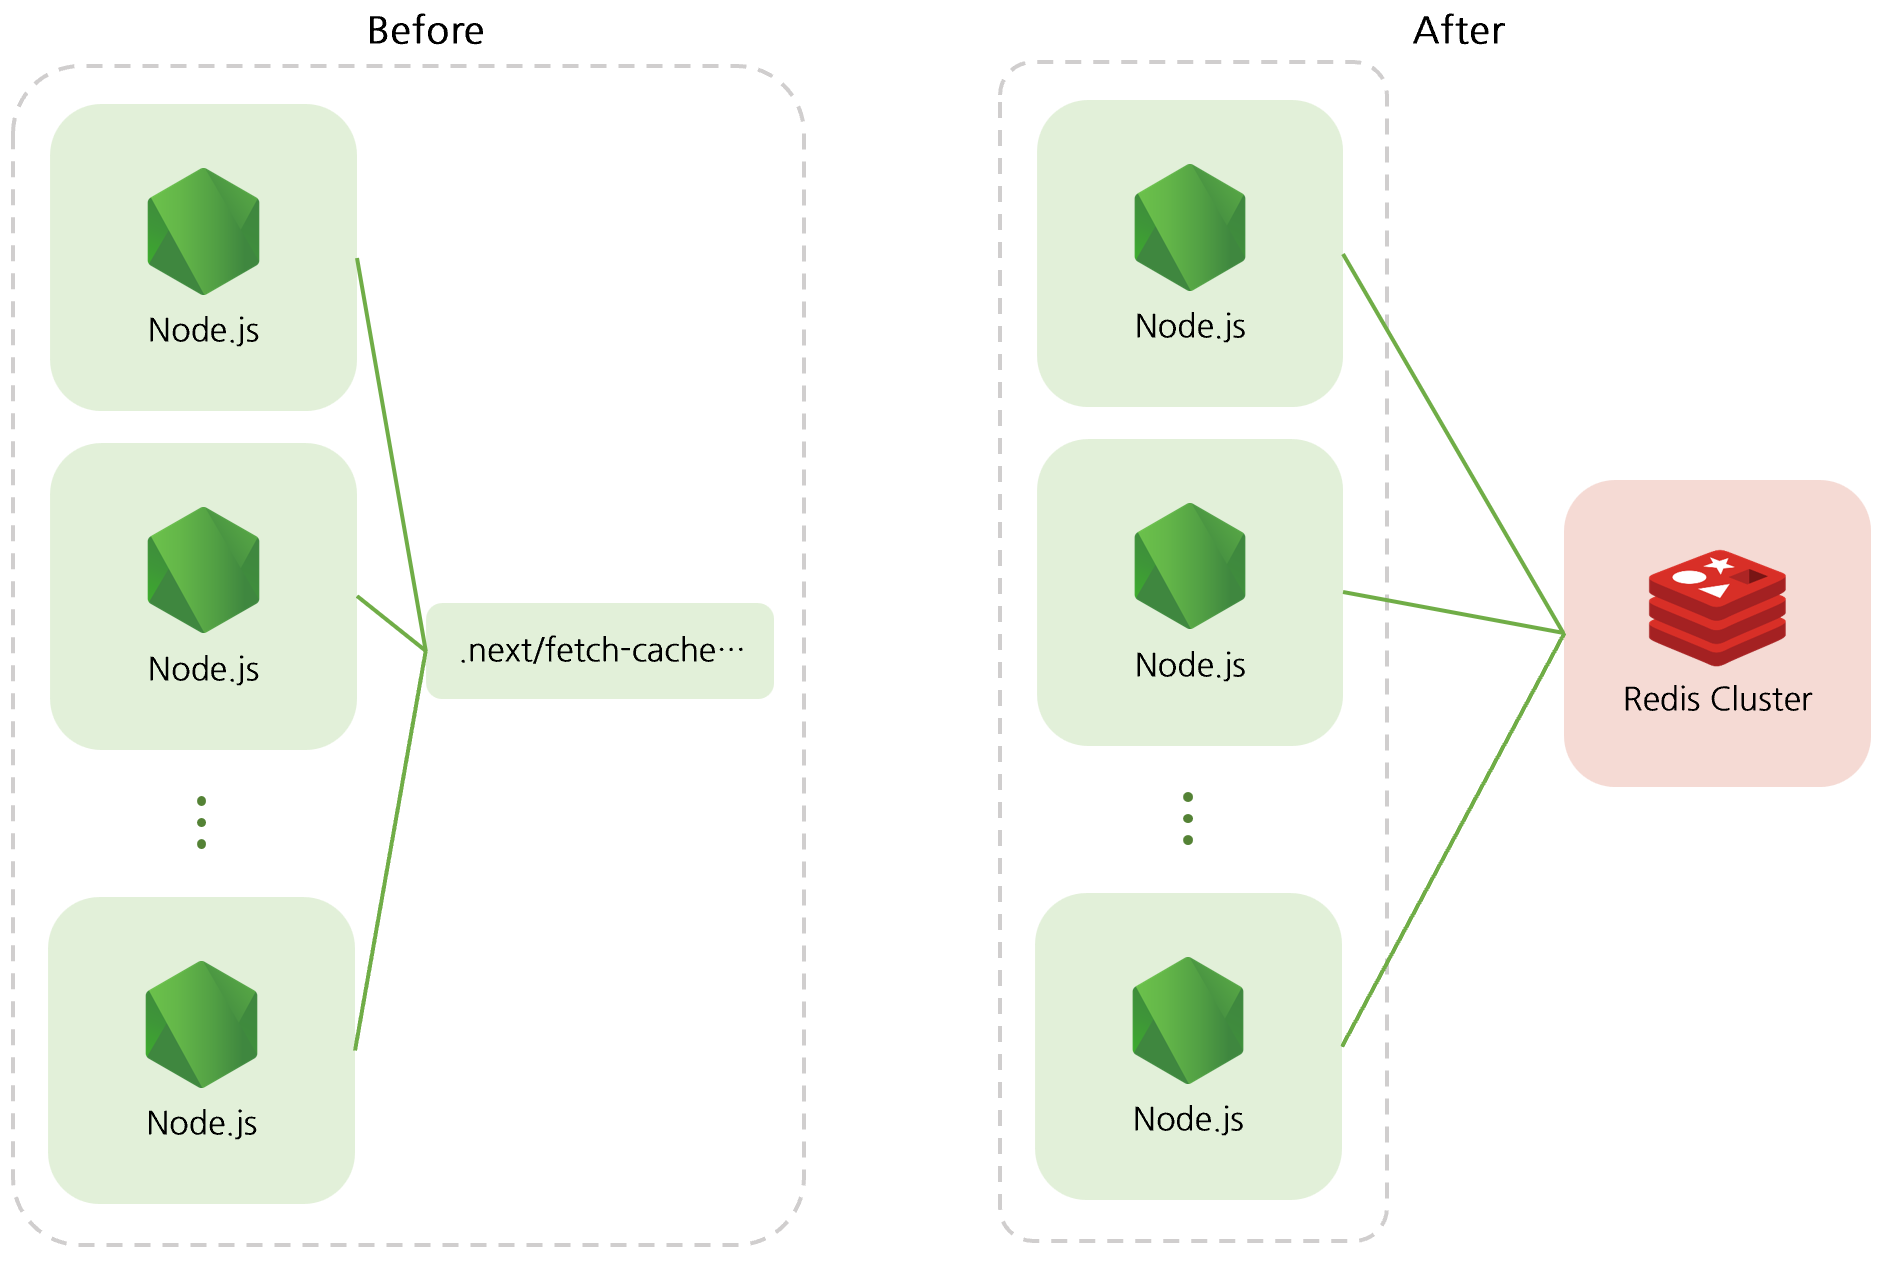
구조를 개선하고 Heap 메모리 효율성과 OOM에 대한 안정성은 정말 많이 좋아졌습니다만 부하 상황에서의 성능에 대한 개선은 크지 않았습니다.
(locust, 30 user 1000 RPS, 동일 시나리오)
방향을 잘못 짚은 것 같으니 다음 해결책을 시도해보기로 했습니다.
두 번째 가설. Event Loop를 무언가 막고 있다!
Node는 하나의 이벤트 루프 내에서 작업을 처리합니다. API 응답을 50ms만에 받고 7000ms나 더 소요되었으니, 통신보다는 런타임 로직 처리에서 이벤트 루프가 막혀서 응답이 지연되었을 확률이 있었습니다.
가장 호출이 많았던 API를 한 번 호출해보고 나서야 원인을 어느정도 짐작할 수 있었습니다. 500KB짜리 거대한 json이 응답으로 떨어지고 있더군요.
{
	"itemCode": "abc123",
	... [500kb]
}
높은 트래픽이 유지되는 상황에서 이 정도 되는 사이즈의 JSON을 직/역직렬화 화는 작업은 Node에 상당한 부하를 줄 수 있습니다.
const response = await fetch(apiUrl)
return await response.json()
1차적으로 응답에서 불필요한 필드들을 제거해서 사이즈를 150KB 정도로 줄였습니다. 그럼에도 가볍다고 할 수준은 아니었기에, 최적화가 더 필요했습니다.
gzip은 전송량을 줄일 수 있지만, Node 내부에서 발생하는 JSON 파싱과 직렬화 비용은 제거하지 못합니다. 압축까지 Node에서 수행한다면 이미 부족한 CPU를 더 사용하게 될 가능성도 있었습니다. 그렇다고 JSON을 작게 쪼개자니 비즈니스 로직을 다시 설계할 시간이 부족했습니다.
고민을 거듭하다가 생각이 하나 떠올랐습니다.
Node가 하지 않아도 되는 일을 없애기
이건 구조적 문제는 아닐까 하는 의심이 들었습니다. 애초에 이 API 응답을 Next.js가 처리할 필요가 있었을까요?
만약 Next.js의 프록시가 별다른 로직 없이 통로로만 사용되고 있다면 그 구조 자체가 병목일 것이라 판단했습니다. 정확히 Public API가 그런 케이스였습니다. 별다른 인증 없이 단순 json 통신만 하고 있었기 때문입니다.
단순 json 통신만 필요한 API들이 프록시를 타지 않도록 개선했습니다. 이 작업 이후에 성능에 즉각적인 변화를 확인할 수 있었습니다. 드디어 이전과 동일한 테스트 환경에서 Node 부하가 크게 줄었습니다.
(locust, 30 user 1000 RPS, 동일 시나리오)
다시 찾아온 이벤트
3일 뒤 예정되었던 이벤트가 시작되었습니다.
완전히 동일한 조건은 아니었지만, 이전 이벤트와 유사한 수준의 TPS가 발생한 이벤트 시작 후 30분을 비교했을 때 Node 애플리케이션의 평균 응답 시간은 약 70% 줄었습니다.
이전처럼 이벤트 시작 직후 Node의 응답이 급격하게 느려지는 현상도 발생하지 않았고, 별다른 장애 없이 이벤트를 마칠 수 있었습니다.
그렇다면 원인은 GC였을까
Node 프록시 레이어를 제거한 뒤 성능이 크게 개선된 걸 확인했지만, 사실 이 결과만으로는 왜 좋아졌는지 완전히 설명되지 않았습니다. 단순히 처리할 요청 자체가 줄어든 걸까요, 아니면 다른 무언가가 함께 개선된 걸까요.
이벤트가 끝난 뒤 다시 heap 사용량 그래프를 들여다봤습니다. 개선 전과 후에 동일한 TPS 구간에서 GC가 발생하는 빈도를 비교해보니 확연한 차이가 있었습니다.
500KB 짜리 JSON을 매 요청마다 파싱하고 가공하는 과정에서, 순간적으로 많은 임시 객체가 생성되었을 것입니다. 이 객체들이 Young Generation을 빠르게 채우면서 Minor GC가 잦아졌고, 그 때 이벤트 루프도 함께 멈췄을 것이라 추정했습니다.
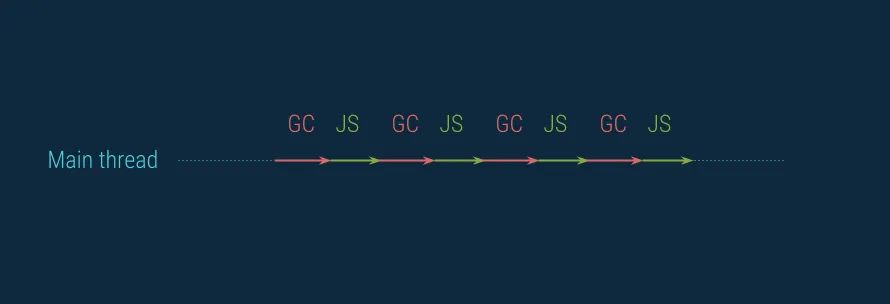
100% 확신할 수 없지만 문제는 “빠른 통신 이후에 발생하는 후처리” 였지 않았을까 합니다. Node의 프록시 레이어를 걷어내면서 다량의 JSON을 처리하는 과정 자체가 사라졌고, 그 결과 GC 횟수도 함께 줄어든 셈이죠.
마무리하며
불확실한 상황에서 무언가를 도전하는 것은 어려운 일입니다. 하지만 그만큼 해결해 냈을 때 그만큼 더 뿌듯한 것 같습니다.
이번에는 정확한 원인을 알지 못한 채로 문제가 해결되어서 찝찝하지만, 다음에는 불확실한 상황에서도 원인까지 파악할 수 있는 더 나은 엔지니어가 되어있었으면 합니다.